最近我们一台托管在Linode的服务器收到了官方的邮件提醒《Linode Alert – inbound traffic rate》,告知服务器入站流量速率在过去 2 小时内平均达到 13.08 Mb/s,超过了通知阈值 (10)。我们登录WP Panel后台查看网站日志,发现大量不同 IP 伪装成常见爬虫,持续请求不存在的 WordPress 页面。它们不是传统意义上的单 IP 暴力攻击,而是通过大量 IPv6 地址分散访问,让按 IP 统计的封禁规则很难第一时间命中。
这次 WP Panel 新增的“爬虫限速”功能,就是为了解决这类问题。
遇到的问题
下面是一段真实访问日志中的片段,User-Agent 都是 meta-externalagent/1.1:
2a03:2880:f800:1a:: - - [16/Jun/2026:09:29:57 +0000] "GET /products/30829608 HTTP/2.0" 404 32601 "-" "meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)"
2a03:2880:f800:9:: - - [16/Jun/2026:09:30:04 +0000] "GET /products/20187920 HTTP/2.0" 404 32608 "-" "meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)"
2a03:2880:f800:23:: - - [16/Jun/2026:09:30:07 +0000] "GET /products/30047886 HTTP/2.0" 404 32604 "-" "meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)"
这些请求有几个特点:
- IP 数量很多,主要来自不同 IPv6 地址。
- 请求路径大量指向不存在的商品页、随机页面或不存在的 sitemap。
- WordPress 会生成动态 404 页面,每次请求仍然会消耗 PHP、数据库和主题/插件执行资源。
- 单个 IP 未必足够频繁,可能不会立刻触发传统 Fail2ban 的按 IP 封禁。
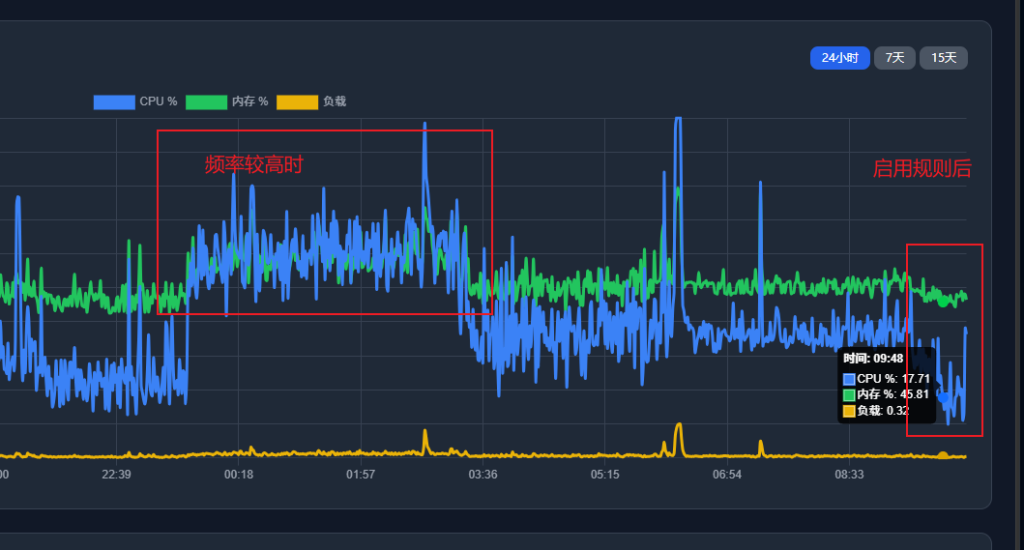
在规则启用前,面板首页资源历史趋势中可以看到,服务器 CPU 平均使用率约在 40% 左右,严重时甚至冲到 100%。这类请求虽然返回的是 404,但并不是“没有成本”的 404,它们会持续打到 WordPress 动态处理链路。
新功能做了什么
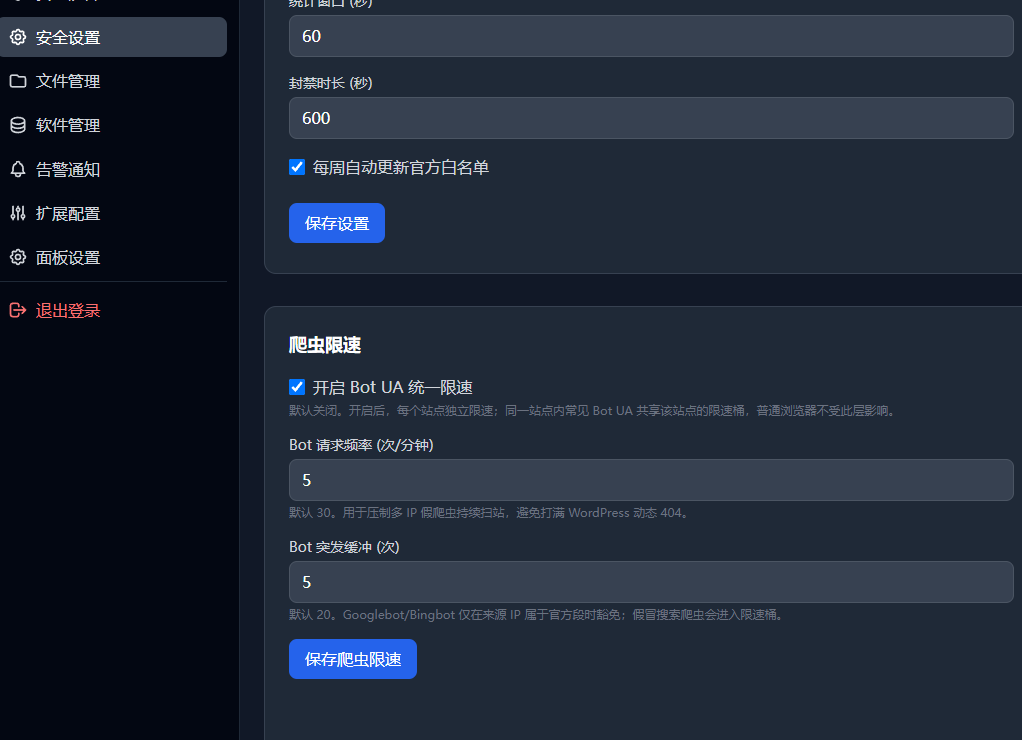
WP Panel 新增了“爬虫限速”安全设置。它默认关闭,管理员可以在“安全设置”页面手动开启。
开启后,系统会识别常见 Bot User-Agent,并按站点建立独立的爬虫限速桶。同一个站点内,命中的 Bot UA 会共享这个站点的爬虫限速额度。这样即使请求来自大量不同 IP,只要它们都在扫描同一个站点,就会被同一个站点级别的限速规则约束。
举个例子:
- 站点 A 开启爬虫限速为 10 次/分钟,突发 10。
- 大量 IP 伪装成
meta-externalagent扫描站点 A。 - 它们不会因为换 IP 就完全绕过限制,而是共同消耗站点 A 的 Bot 限速桶。
- 超过限速后,Nginx 直接返回 429,不再把请求继续交给 WordPress 动态处理。
这和传统按 IP 封禁是互补关系。Fail2ban 仍然会继续统计 429、404 等异常行为,并在单个 IP 达到阈值后封禁;而爬虫限速解决的是“IP 太分散,单 IP 不容易马上达到封禁阈值”的问题。
启用后的效果
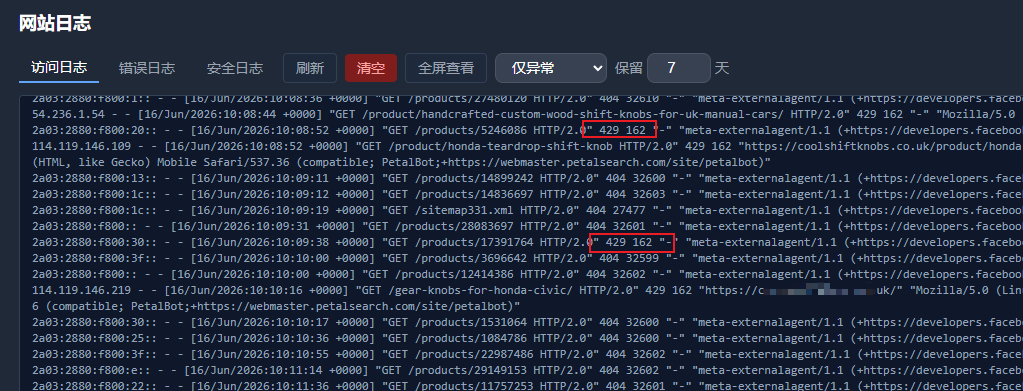
规则生效后,同一批访问日志开始出现 429:
2a03:2880:f800:29:: - - [16/Jun/2026:09:32:45 +0000] "GET /products/6203442 HTTP/2.0" 429 162 "-" "meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)"
2a03:2880:f800:38:: - - [16/Jun/2026:09:32:49 +0000] "GET /products/19564875 HTTP/2.0" 429 162 "-" "meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)"
2a03:2880:f800:3e:: - - [16/Jun/2026:09:32:51 +0000] "GET /products/19045608 HTTP/2.0" 429 162 "-" "meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)"
这组日志里有一个很直观的变化:
- 404 动态页面响应体约 32KB。
- 429 限速响应体只有 162B。
- 429 由 Nginx 在前置层直接返回,请求不会继续打到 WordPress。
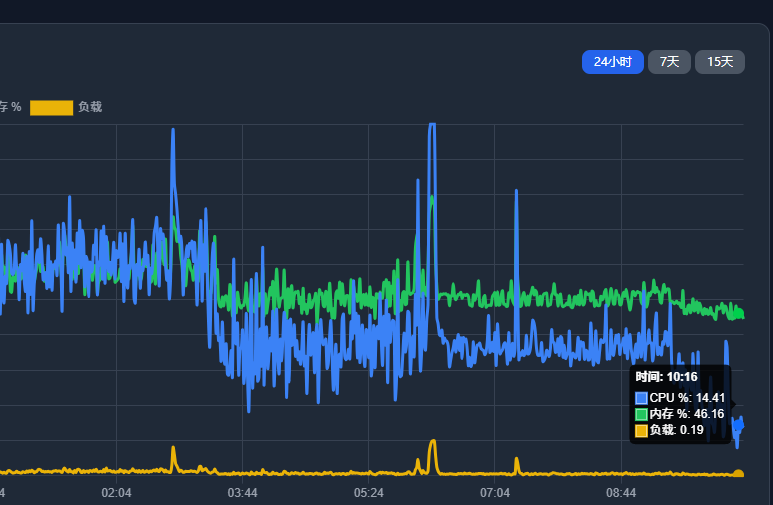
在这次线上测试中,由于攻击来源 IP 很多,并不是每个 IP 都能快速触发到 Fail2ban 的封禁阈值;但是爬虫限速已经在站点层面对流量进行了削峰。规则生效后,CPU 使用率从之前平均约 40% 降低到 30% 附近,对服务器压力有明显缓解。
会不会影响正常用户访问?
不会影响普通浏览器访问。
爬虫限速只针对命中 Bot UA 规则的请求生效,普通用户的浏览器 User-Agent 不会进入这层限速。普通访客仍然按照站点正常规则访问。
同时,这个功能是按站点独立生效的。一个服务器上有多个站点时,每个站点都有自己的爬虫限速桶,不是所有站点共享一个总额度。
会不会影响 Google 和 Bing 抓取?
WP Panel 对搜索引擎做了额外保护。
Googlebot 和 Bingbot 不只是看 User-Agent。系统会定期拉取 Googlebot、Bingbot 的官方 IP 段,并在 Nginx 里验证来源 IP。只有来源 IP 命中官方 IP 段时,才会豁免爬虫限速。
这意味着:
- 真 Googlebot / Bingbot:来源 IP 属于官方段时,不受新增爬虫限速影响。
- 假冒 Googlebot / Bingbot:只有 UA 像搜索引擎,但 IP 不在官方段,会进入爬虫限速桶。
- 其他常见 Bot:例如 Meta/Facebook、Twitterbot、LinkedInBot、Slackbot 等,会按管理员设置进入爬虫限速。
这样做的目的,是避免“只要写一个 Googlebot UA 就能绕过防护”的问题,同时尽量保护正常搜索引擎抓取。
默认支持识别哪些 Bot?
当前默认匹配以下常见 Bot:
- Googlebot
- Bingbot
- facebookexternalhit
- meta-externalagent
- Twitterbot
- LinkedInBot
- Slackbot
- Discordbot
- TelegramBot
- SemrushBot
- AhrefsBot
- MJ12Bot
- DotBot
- UA 中包含
bot、crawler、spider、scraper、scan的请求
这些规则覆盖了常见搜索引擎、社交平台预览抓取、SEO 工具扫描和通用爬虫特征。
建议如何设置?
爬虫限速默认关闭,需要管理员手动开启。
默认建议值是:
- Bot 请求频率:30 次/分钟
- Bot 突发缓冲:20 次
如果当前正在遭遇明显扫描,可以临时调低,例如 10 次/分钟、突发 10。这个设置会更快出现 429,能更明显地降低动态 404 对 WordPress 的压力。
如果站点依赖社交平台频繁抓取分享预览,或者页面更新后需要平台快速刷新预览,可以先使用默认值观察,不建议一开始设置得过低。
如何判断规则已经生效?
最简单的判断方法,查看网站日志,如果看到同一类 Bot 请求开始返回 429,就说明爬虫限速已经生效。后续如果同一个 IP 在统计窗口内持续触发 429,Fail2ban 也会继续按封禁规则处理。
总结
这次新增的爬虫限速,不是为了禁止所有 Bot,也不是替代 Fail2ban,而是补上一个过去比较容易被绕开的场景:大量 IP 伪装成常见爬虫持续扫站。
它的核心价值是:
- 在 Nginx 层提前拦截过量 Bot 请求。
- 减少无效动态 404 打到 WordPress。
- 对大量换 IP 的爬虫扫描进行站点级削峰。
- 保留 Googlebot/Bingbot 官方 IP 豁免,降低对正常搜索引擎抓取的影响。
- 与 Fail2ban 继续配合,对重复违规 IP 做封禁。
对于正在遭遇类似扫描的站点,这个功能可以作为一个低成本、可回滚、默认关闭的防护开关,在不影响普通访客访问的前提下,帮助服务器把资源留给真正的用户。